

实战:Prometheus + Alertmanager 接入钉钉实现多节点容器告警闭环
在多节点云服务器架构中,单纯使用 Prometheus 配合 cAdvisor / Node Exporter 抓取指标往往只完成了监控体系的前半段。真正保障线上业务高可用的关键,在于当容器或服务出现异常时,告警能实时、准确地触达运维人员终端(如钉钉群推送)。
本文基于二进制部署环境,记录如何打通 Prometheus -> Alertmanager -> prometheus-webhook-dingtalk -> 钉钉群机器人 的完整告警链路,并总结排查过程中的避坑要点。
一、整体架构链路
Alertmanager 原生并不直接支持钉钉的卡片消息协议,因此需要引入一层轻量级适配器进行协议转换:
Plaintext
[ Prometheus (9090) ]
       │  (评估告警规则,触发 Firing)
       ▼
[ Alertmanager (9093) ]
       │  (告警去重、分组聚合、静默与路由)
       ▼
[ prometheus-webhook-dingtalk (8060) ]
       │  (将 Prometheus 告警 JSON 转换为钉钉 Markdown 格式)
       ▼
[ 钉钉 OpenAPI (公网) ] ───> [ 钉钉群 / 移动端弹窗 ]
二、部署与配置步骤
1. 钉钉机器人准备
打开目标钉钉群:群设置 -> 智能群助手 -> 添加机器人 -> 自定义(通过 Webhook 接入)。
安全设置:建议勾选 自定义关键词(例如填入
告警或ContainerDown)。保存后获取专属的 Webhook 地址:
[https://oapi.dingtalk.com/robot/send?access_token=YOUR_ACCESS_TOKEN](https://oapi.dingtalk.com/robot/send?access_token=YOUR_ACCESS_TOKEN)
2. 部署 prometheus-webhook-dingtalk
该组件监听本地 8060 端口,接收 Alertmanager 投递的告警,并转发给钉钉。
(1)下载与配置
Bash
cd /opt
wget https://github.com/timonwong/prometheus-webhook-dingtalk/releases/download/v2.1.0/prometheus-webhook-dingtalk-2.1.0.linux-amd64.tar.gz
tar -zxf prometheus-webhook-dingtalk-2.1.0.linux-amd64.tar.gz
mv prometheus-webhook-dingtalk-2.1.0.linux-amd64 prometheus-webhook-dingtalk
cd prometheus-webhook-dingtalk
编写 config.yml:
YAML
targets:
  dingding_webhook:
    url: https://oapi.dingtalk.com/robot/send?access_token=YOUR_ACCESS_TOKEN
避坑提醒:YAML 格式严禁使用 Tab 制表符缩进,必须使用空格,否则启动会报
found character that cannot start any token。
(2)配置 Systemd 服务
创建 /etc/systemd/system/prometheus-webhook-dingtalk.service:
Ini, TOML
[Unit]
Description=Prometheus Webhook Dingtalk
After=network.target

[Service]
Type=simple
User=root
ExecStart=/opt/prometheus-webhook-dingtalk/prometheus-webhook-dingtalk --config.file=/opt/prometheus-webhook-dingtalk/config.yml
Restart=on-failure

[Install]
WantedBy=multi-user.target
启动并加入自启:
Bash
systemctl daemon-reload
systemctl enable --now prometheus-webhook-dingtalk
3. 部署 Alertmanager
Alertmanager 作为告警中心,负责接收告警并控制推送频次。
(1)下载与配置
Bash
cd /opt
wget https://github.com/prometheus/alertmanager/releases/download/v0.27.0/alertmanager-0.27.0.linux-amd64.tar.gz
tar -zxf alertmanager-0.27.0.linux-amd64.tar.gz
mv alertmanager-0.27.0.linux-amd64 alertmanager
cd alertmanager
编写 alertmanager.yml:
YAML
global:
  resolve_timeout: 5m

route:
  group_by: ['alertname', 'instance']
  group_wait: 10s       # 告警触发后等待10秒合并同类项
  group_interval: 1m    # 同一组内有新增告警时的刷新间隔
  repeat_interval: 1h   # 故障持续存在时,重复告警的间隔时间(防止告警风暴)
  receiver: 'dingtalk'

receivers:
- name: 'dingtalk'
  webhook_configs:
  - url: 'http://localhost:8060/dingtalk/dingding_webhook/send'
    send_resolved: true # 故障恢复后自动向钉钉推送恢复通知
(2)配置 Systemd 服务
创建 /etc/systemd/system/alertmanager.service:
Ini, TOML
[Unit]
Description=Prometheus Alertmanager
After=network.target

[Service]
Type=simple
User=root
ExecStart=/opt/alertmanager/alertmanager --config.file=/opt/alertmanager/alertmanager.yml
Restart=on-failure

[Install]
WantedBy=multi-user.target
启动并加入自启:
Bash
systemctl daemon-reload
systemctl enable --now alertmanager
4. 配置 Prometheus 关联告警与规则
(1)修改 prometheus.yml
在最外层(与 global:、scrape_configs: 处于同一层级,顶格书写)追加告警和规则路径:
YAML
alerting:
  alertmanagers:
    - static_configs:
        - targets:
            - localhost:9093

rule_files:
  - "rules.yml"
避坑提醒:在纯二进制直接运行的环境下,主机名不能写成容器服务名(如
alertmanager:9093),系统无法完成本地 DNS 解析,必须使用localhost:9093或127.0.0.1:9093。
(2)编写容器宕机告警规则 rules.yml
在 prometheus.yml 同级目录下新建 rules.yml:
YAML
groups:
- name: container_alerts
  rules:
  - alert: ContainerDown
    # 当 cAdvisor 抓取的容器超过 60 秒未上报指标时判定异常
    expr: time() - container_last_seen{name!=""} > 60
    for: 1m
    labels:
      severity: critical
    annotations:
      summary: "容器宕机告警: {{ $labels.name }}"
      description: "服务器 {{ $labels.instance }} 上的容器 [ {{ $labels.name }} ] 已停止运行,请及时检查。"
重启 Prometheus 服务:
Bash
systemctl restart prometheus
三、告警生命周期与故障演练
Prometheus 告警状态严格遵循三段流转:
Inactive(绿色):指标一切正常。
Pending(黄色):指标超过阈值(如停止上报 > 60s),等待
for: 1m持续时间确认,防止网络偶发抖动造成误报。Firing(红色):持续时长满足,正式生成告警事件推送到 Alertmanager。
演练测试
在测试机器上启动临时容器并停止:
Bash
docker run -d --name test-nginx nginx
docker stop test-nginx
观察 Prometheus Web 控制台(
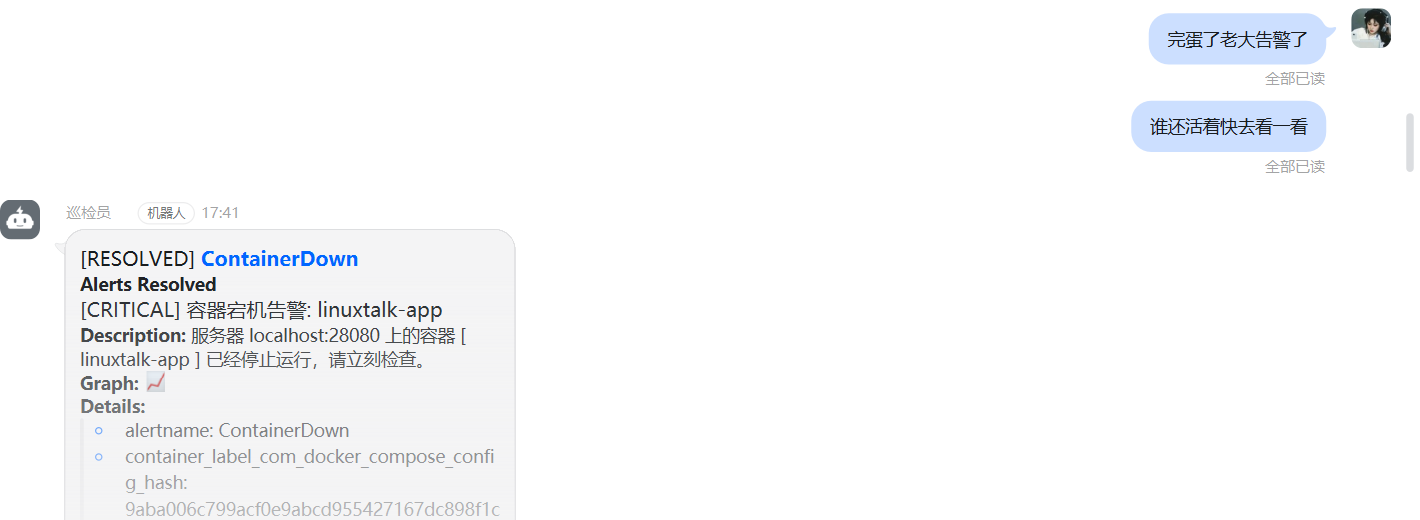
http://IP:9090/alerts),规则由 Inactive -> Pending -> Firing。钉钉群内随即收到告警卡片,包含容器名称与所在主机节点。
重启或销毁容器后,等待指标恢复,钉钉群将收到自动恢复(Resolved)通知。
四、核心排查经验总结
链路上游至下游逐级排查
Prometheus 状态:在 Prometheus 页面检查
Status -> Alertmanagers是否成功发现localhost:9093。若显示为 0,优先检查 YAML 缩进与顶格配置。Alertmanager 状态:查看
journalctl -u alertmanager是否有error,在本地使用curl -i http://localhost:9093验证健康度。Webhook 转换器状态:使用
curl模拟向http://localhost:8060/dingtalk/dingding_webhook/send提交测试 JSON,能快速隔离“网络与转换组件”与“监控采集”两大段。
为什么钉钉只告警两次就停了? 并非告警失效,而是 Alertmanager 的
repeat_interval: 1h机制生效。在同一故障持续存在期间,系统避免告警风暴刷屏,默认每隔 1 小时重复一次通知。如需高频跟进,可适当下调此参数至10m。端口暴露原则 Prometheus、Alertmanager(9093)、钉钉转换器(8060)均运行在同台机器时,配置
localhost走 Linux 环回网络最为安全高效。切勿为了调用而将8060暴露给公网安全组,因为转换器本身未设鉴权机制,开放公网可能导致群接口被外部滥用。
可以看到报警之后待处理的信息(不沾)
核心困惑:
在梳理和搭建这套多机监控与告警链路的过程中,核心困惑主要集中在以下四个方面:
链路架构与协议转换的认知(为什么不能直连钉钉)
困惑点:起初以为 Prometheus 产生告警后能直接推给钉钉群,不清楚为什么中间需要插一个 Alertmanager,甚至还要额外跑一个 prometheus-webhook-dingtalk。
本质理解:Prometheus 只负责通过 PromQL 计算告警规则;Alertmanager 负责告警的去重、分组与抑制;而钉钉有自己专有的卡片 JSON 协议,原生 Alertmanager 无法直接解析,必须依赖中转适配器做协议格式转换。
服务通信模式与网络环境的混淆(为什么访问失败 / 需不需要公网)
困惑点:
配置 Alertmanager 时写了 - alertmanager:9093,误以为宿主机能像 Docker Compose 那样直接识别容器服务名,导致报域名解析错误 DNS_PROBE_FINISHED_NXDOMAIN。
告警未送达时,怀疑是不是云服务器安全组未放通端口;后来又疑惑是否需要把本地调用的地址改成公网 IP 加端口。
本质理解:所有监控核心组件(Prometheus、Alertmanager、钉钉适配器)都在同一台机器上以二进制运行,通过 Linux 本地环回网络(localhost / 127.0.0.1)通信既最安全(不暴露未鉴权端口给公网)又不受网络波动影响。
告警生命周期与流转策略的疑惑(为什么钉钉只发了两次就不发了)
困惑点:测试容器宕机时,钉钉群响了两次之后便不再收到新通知,误以为告警链路出现故障或配置失效。
本质理解:这是 Alertmanager 的防告警风暴机制在起作用。配置中的 repeat_interval: 1h 决定了当同一个故障持续存在且未产生新变化时,系统默认每隔 1 小时才会重复提醒一次。
数据采集逻辑与变量来源的解耦(Prometheus 是怎么跨机器监控的、数据从哪来)
困惑点:
一台机器上的 Prometheus 是如何把两台不同服务器上的容器与主机状态全部拉回来的。
为什么在监控容器时没有给每一个容器单独指定请求目标。
PromQL 规则里的 node_cpu_seconds_total、{{ $labels.nodename }} 等变量到底是系统自带的还是手动定义的。
本质理解:Prometheus 采用 Pull(拉取)模型,通过定时轮询每台机器上开放的 metrics_path(/metrics)获取纯文本指标;每台机器只需单点运行一个 cAdvisor 或 Node Exporter 即可汇聚整机数据;指标本身由探针生成,而像 nodename 这类业务标签则是在 prometheus.yml 抓取目标中手动打上的元数据。
实战:Prometheus + Alertmanager 接入钉钉实现多节点容器告警闭环
https://originspace.work/archives/shi-zhan-prometheus-alertmanager-jie-ru-ding-ding-shi-xian-duo-jie-dian-rong-qi-gao-jing-bi-huan
评论